第104回 ヒトゲノムのほぼすべての一塩基変異をAIで予測-アルファゲノム・アトラスが登場
1.はじめに
本年9月、米国のグーグル・ディープマインド社は、AIを用いて、ヒトゲノムで生じる可能性のあるほぼ全ての一塩基変異について、その影響を予測したデータベース「アルファゲノム・アトラス」(AlphaGenome Atlas)を公開した。今回はこのデータベースの背景、特徴、意義・課題等について分析・考察を行うこととする。
2.生命科学分野でのAIによる予測の進展
今回発表のアルファゲノム・アトラスの元となったアルファゲノム(AlphaGenome)については、既に本ニュースレター(第90回 ゲノムの変異による影響を解明するAIモデルが登場)で紹介したが、AIを用いた生体物質の解析の進展について、今一度簡単に経緯を述べる。
(1)遺伝子産物の予測
AIがまず取り組んだ生体物質は、ゲノムではなく、タンパク質だった。これについては、AIによる構造・機能の解明が大いに進展してきている。
ディープマインド社は、AIソフト「アルファフォールド」を用いて、膨大な既知のタンパク質構造とアミノ酸配列のデータを学習させ、決定に数年かかっていたタンパク質の構造を、数十分で精度よく予測できるようにした。アルファフォールド2ではいっそう進化し、予測されたタンパク質構造は2024年末の段階で2億を超え、当然ながらヒトゲノム中の2万~2万2千個の遺伝子産物もそれに含まれていた。この研究を主導したデミス・ハサビス氏とジョン・ジャンパー氏は、2024年のノーベル化学賞を受賞した。なお、この方法により、遺伝子が変異した場合、それによるタンパク質の微妙な構造変化の予測がある程度可能になった。
(2)これまでのアルファゲノムの成果
このようにAIによる生命現象の予測は、当初タンパク質が先行したが、その後ゲノムへと対象を広げてきた。
ゲノムは約30億塩基対からなるが、そのうちタンパク質をコードするのは約2%にすぎない。しかし、それ以外の非コード領域も、RNAになる部位や、調節遺伝子の領域、スプライシングで切り取られるイントロン領域等、さまざまな領域が存在する。それらの機能を全て予測するのは、1つ1つの実験を通じてだと極めて手間がかかり、困難だった。
これに対し、ディープマインド社は、従来のゲノム予測モデル「エンフォーマー(Enformer)」を基に、ENCODEやGTExなど、ヒト及びマウス由来の大規模な公開データセットでトレーニングすることにより、アルファゲノム(AlphaGenome)という大規模な予測モデルを構築した。
アルファゲノムは、長大なDNAシーケンスを一度に解析し、しかも遺伝子発現に関する情報(RNA-seq、CAGE、PRO-cap等)のほか、スプライシング部位、転写因子の結合箇所、クロマチンの立体構造など、ゲノムに関わる11種類の主要な機能を同時に予測できる統合モデルとなった。たとえば、ノンコーディング領域においてある塩基が変異したら、別の遺伝子のRNAスプライシングがどう変わるか、発現量がどう変わるか、クロマチンの状態はどう変わるか等が、一目でわかるようにした。
従来の手法としては、発現量予測専用モデル、スプライシング予測専用モデル等があったが、それぞれ対象とする現象ごとにモデルを使い分ける必要があった。しかしこのアルファゲノムにより、単一モデルで網羅的なゲノム機能の予測を行えるようになった。
3.アルファゲノム・アトラスについて
(1)予測するモデルから全変異を予測済みの地図に
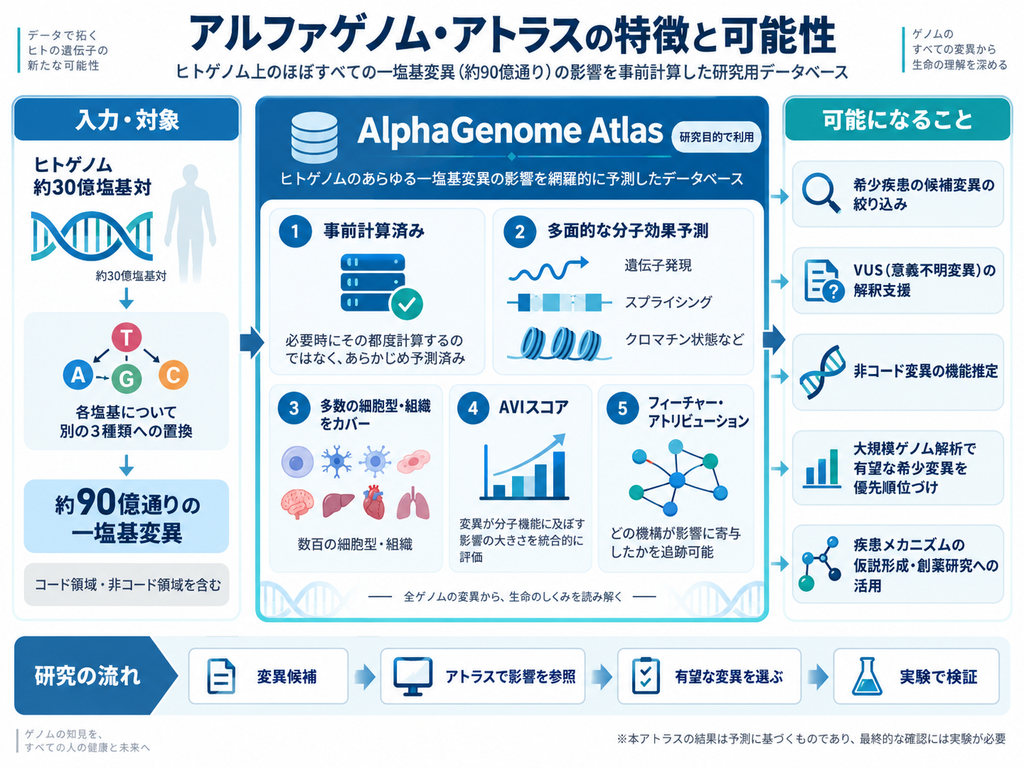
グーグル・ディープマインド社は、本年9月、アルファゲノム・アトラス(以下「アトラス」と呼ぶ)というデータベースを発表した。これまでのアルファゲノムでは、必要な変異についてその都度計算し、解を求めていた。だがアトラスでは、ヒトゲノム上で生じる1塩基変異のほぼ全部について、あらかじめ計算済みにしたデータベースに発展させたのである。
先述のようにヒトゲノムは約30億塩基対からなる。ゲノムを形成する塩基の種類はATGCの4種類であるため、30億のぞれぞれの塩基について、元と異なる3種類の塩基への置換がなされた場合、つまり30億×3=90億種類のバリエーションができることになる。アトラスには、それぞれについて、どうなるかを計算したものが搭載されている。具体的には、それぞれの変異について、数百種類のヒト及びマウスの細胞型と組織にわたる、数千もの分子効果予測を掲載したのである。データ量は、アルファ・フォールドデータベースの30倍以上で、何と1ペタバイトにもなる。
(2)新たなAVIスコアを作成
アルファ・ゲノムは、一つの変異について、発現、スプライシング、クロマチンアクセシビリティ等の多数の予測を行う。このような豊富なデータは、研究には有用だが、一方で、ある変異が重要な変異かどうかをすぐには判断しにくいという問題があった。そこで新たにアルファゲノム・バリアント・インパクト(AVI)という指標が開発された。
AVIは、アルファゲノムに加え、タンパク質コード領域の変異を評価するアルファ・ミスセンスというシミュレーションモデルのデータ等、多数の予測結果を統合した。そして、その変異が生体の分子機能にどの程度大きな影響を与える可能性があるかを、一つのスコアで示すようにした。これは、コーディング領域だけでなく、ノンコーディング領域についても同じ枠組みで扱う、画期的な指標である。このスコアは、既知の病原性変異を識別するベンチマークでも高い性能を示した。
なお、AVIには、フィーチャー・アトリビューションという機能が付随している。たとえば、「この変異はスプライシングを壊す」「この変異はクロマチン構造を変える」「この変異は遺伝子発現調節に影響する」といった各種観点から、スコアの内訳を追えるようになっている。
さらに、アトラスには、ゲノム上に繰り返し現れる2,500種類を超えるDNA配列モチーフと、その位置情報も収載されている。こうしたモチーフは、いわばゲノムを構成する「単語」のような短い配列で、転写因子の結合部位など、遺伝子発現を調節する領域を読み解く手掛かりになる。この情報を分子効果予測やAVIスコア、フィーチャー・アトリビューションと組み合わせることにより、ある変異がどの調節配列を壊し、どのような仕組みで遺伝子機能に影響する可能性があるのかを、より具体的に追えるようになった。
4.アルファゲノム・アトラスの意義・課題
このようにアトラスは、①各変異についての数千の分子効果予測、②変異の重要度を一つの数値で示すAVIスコア、③そのスコアを生み出した分子機構を示すフィーチャー・アトリビューション、④2,500種類を超えるDNA配列モチーフ、という情報を相互に結び付けている。そのため研究者は、膨大な変異の中から重要そうなものをまず絞り込み、次に「なぜその変異が影響を及ぼすのか」を遺伝子発現、スプライシング、クロマチン、調節配列などの観点から掘り下げることができる。これにより、疾患に関係する候補変異の順位づけだけでなく、その分子機構を踏まえた仮説を立て、実験で検証すべき対象を効率よく選ぶことが可能になり、創薬研究への応用も期待される。
また、従来のアルファゲノム では、「遺伝性疾患の可能性やVUSの解釈に役立つ可能性」といった可能性が提示されていただけだったが、今回は、その可能性から一歩進んだ。米国ブロード研究所などの研究者は、未解決の希少疾患の症例でアトラスを使い、DNM1遺伝子に関係するノンコーディング変異を候補として浮上させた。アルファゲノムはその変異が異常なスプライス部位を作ると予測し、その後の実験でも支持されたとのこと。
さらに、対象は個別疾患だけでなく集団遺伝学にも広がった。アトラスは、数万人規模の全ゲノム解析から、意味のありそうな希少変異だけを濃縮する用途にも試されている。UKバイオバンクの約5万4千人の解析では、AVIなどを用いて影響が大きいと予測された非コード変異を絞り込み、BMIと関係する19の遺伝領域を見いだした。つまり、一つの変異の解釈から、全ゲノム・大集団に存在する膨大な変異をふるいにかけ、次に調べるべき候補を効率よく抽出する基盤へと用途が広がっている。
そうして、研究者の仕事は、一つ一つの変異をその都度計算することから、巨大な「地図」を使って候補を絞り込み、影響の仕組みを読み解き、そこから仮説を立てて、どこを実験で確かめるかを決める方向へと移りつつある。
ただ、このデータベースでは、変異の結果として導かれる現象はあくまで予測であり、最終的には実験によって確認される必要がある。また、現在のアトラスが網羅的に事前計算して収載しているのは1塩基置換であり、挿入・欠失や構造変異、複数の変異が組み合わさった場合までを網羅した「地図」にはなっていない。今後、予測モデルのシミュレーション範囲やアトラスのカバー範囲を広げていくことも必要だろう。
なお、グーグル・ディープマインド社は、本アトラスを、研究目的のためなら無料で開放することにしており、これを世界の研究者が利用することにより、その結果も取り込んで、アトラス自体の充実・拡張が大いに期待される。
5.おわりに
かつては、ある形質を司る遺伝子を見出したり、疾患の原因となる遺伝子変異を見出すことで、論文ができ、主要誌に掲載されるという時代があった。それこそが生命の神秘を紐解く方法であり、生命科学者らは、その神秘の解明に向けて貢献することで、使命感のようなものを持てていたと思う。しかし、ヒトゲノム計画をはじめ各種のオミックスによる生体物質の全情報が解明されてくると、生命の設計図を構成する膨大な情報そのものは、次第に全貌を現してきた。アトラスなどはその急先鋒を担っているといえるだろう。
そうなると、生命科学の研究者らの役割は終わったかというと、決してそうではない。そうして得られたデータ量が半端ではないからこそ、その宝の山の中から真に大切なものを見出していく時代がやってきている。しかも、その手法としては、コンピュータやAIを用いたイン・シリコでの解析の比重が大きくなり、そこで得られた仮説をイン・ビトロ(試験管内)やイン・ビボ(生物内)の実験によって検証するという研究の流れが、ますます重要になっていくのではないか。
つまり、生命科学は、未知の情報を一つずつ発見する時代から、膨大な情報の中から意味を読み解くことが主体となり、最後に行う実験はあくまで答え合わせだという時代へと移りつつあるのである。すごい時代の到来であり、さらに今後の進展に期待したい。
参考文献
・AlphaGenome Atlas team”AlphaGenome Atlas: A predictive map of every possible DNA letter change in the human genome” (2026/9/8) Google DeepMind HP
https://deepmind.google/blog/alphagenome-atlas-a-predictive-map-of-every-possible-dna-letter-change-in-the-human-genome
・E. Callaway, “DeepMind’s new genome ‘atlas’ charts effects of all nine billion human gene mutations” (2026/9/9) Nature HP
https://www.nature.com/articles/d41586-026-02835-4
・山形方人「Googleの次なる「アルファ」:アルファゲノムアトラスがヒトゲノムの全塩基変異を予測する」(2026/9/11)News Picks HP https://newspicks.com/news/17483889/body/
ライフサイエンス振興財団理事兼嘱託研究員 佐藤真輔